AI 讀得懂您的網站嗎?別讓商品與服務資訊被漏掉
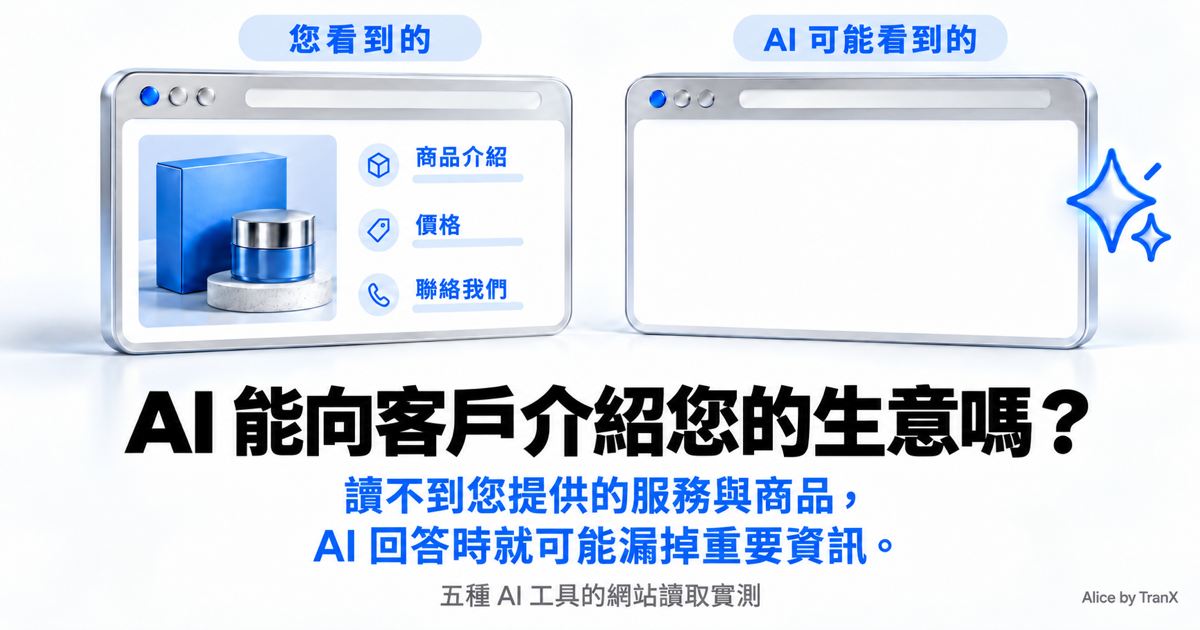
有人問 AI「這家公司賣什麼?價格多少?適合我嗎?」時,AI 能不能讀到您網站上的商品、價格與服務資訊?網站在您眼裡看起來完整,不代表每一種 AI 工具都能讀到裡面的文字。讀不到,就可能在回答潛在客戶時漏掉重要資訊。
讀得到,有助於 AI 了解您的生意;但不保證它會找到、引用或推薦您。這篇實驗只測其中一個環節:直接把網址交給 AI,請它讀網頁,會發生什麼事。至於客戶不給網址、只問公司名稱時 AI 能不能找到資料,還是另一個問題。
我們虛構了一家公司,替它編了吉祥物、地名與價格,再用五種不同方式把資料放上網站。接著請 ChatGPT、Claude 與 Gemini 閱讀。在其中三個頁面,五種 AI 工具有四種沒讀到這些資料;但人用瀏覽器打開時,每一頁看起來都很正常。
先說結論:把重要文字直接放在伺服器送出的網頁內容裡,是本次測試最穩定的做法。有些網站要等程式執行後才加入文字,或把資料藏在程式區塊裡。人不會察覺差別,多數受測工具卻讀不到。ChatGPT App 找到了繞路的方法,後面會說明。
我們曾在英文文章〈AI 如何讀取您的網站〉談過這個問題。在約 100 個使用者提交免費掃描的網站中,也有 6 個在程式執行前幾乎沒有文字。這是提交掃描網站的觀察,不能當成所有網站的比例。因此我們決定實際測試,而且用網路上其他地方沒有的資料。
實驗怎麼設計?同樣三項資料,五種送達方式
這家虛構公司「賣」給獨立書店使用的軟體,網站放在全新網域。每個產品頁都寫了三項編造的資料:最初測試的城鎮、吉祥物名稱與月費。每頁頁尾都註明公司是虛構的,沒有商品真的在販售。
我們暫時不公開公司名稱、網址及編造的答案,以免 AI 從本文或轉載文章學到,而不是從實驗網站讀到。第二篇再公開。
| 頁面 | 資料怎麼送來 |
|---|---|
| 1 | 文字直接放在 HTML,也就是伺服器送出的網頁內容裡。 |
| 2 | 文字只放在另一份 JavaScript 程式檔裡,類似許多 React 或 Vite 應用程式。 |
| 3 | 同樣只在 JavaScript 檔裡,但資料經過編碼,必須執行或解讀程式才會出現。 |
| 4 | 資料在 HTML 的 JSON script 區塊裡,但不是頁面上直接可見的文字。 |
| 5 | 用真正的 Next.js App Router 製作:一項資料由伺服器直接產生、一項稍後串流送達、一項由瀏覽器裡的程式加入。 |
同樣的商品資訊,送達方式不同,結果就不同
像把菜單直接貼在門口
文字隨網頁一起送來,AI 打開就能讀。
本次測試:五種工具都讀到第 1 頁的三項資料。
像菜單另外放在信封裡
沒有商品文字
裡面才有資料
您的瀏覽器會把它們組合起來,AI 卻可能只讀到外殼。
本次測試:五種工具中,四種沒讀到第 2、3 頁的資料。
給 AI 一個網址,它讀到了什麼?
2026 年 10 月 21、22 日,我們把頁面網址交給每個 AI,請它列出頁面上的所有事實。同時查看伺服器紀錄,確認誰下載了網頁,以及有沒有另外下載 JavaScript 檔案。
| 資料送達方式 | ChatGPT App | Claude App | Gemini App | ChatGPT API | Claude API |
|---|---|---|---|---|---|
| 1:文字直接在網頁裡 | 三項皆讀到 | 三項皆讀到 | 三項皆讀到 | 三項皆讀到 | 三項皆讀到 |
| 2:文字只在另外的程式檔裡 | 三項皆讀到 | 未讀到 | 未讀到 | 未讀到 | 未讀到 |
| 3:程式檔裡的文字經過編碼 | 三項皆讀到 | 未讀到 | 未讀到 | 未讀到 | 未讀到 |
| 4:文字藏在網頁的資料區塊裡 | 三項皆讀到 | 未讀到 | 未讀到 | 未讀到 | 未讀到 |
第 2 至 4 頁,五種工具中有四種只看到網站描述、頁尾,以及缺少實驗資料的頁面。紀錄也吻合:ChatGPT-User、Claude-User 與 Google 的擷取工具只索取網頁,沒有再下載 JavaScript。第 4 頁的資料明明已在 HTML 裡,只因放在 script 區塊,仍被略過。
有一點值得放心:讀不到資料的工具都明說找不到,沒有憑空編答案。Claude 還推測文字可能要由瀏覽器執行 JavaScript 才會出現,正是我們的設計。
為什麼 ChatGPT App 讀到了?
ChatGPT App 找到了所有隱藏資料,包含經過編碼的內容。第 3 頁的紀錄顯示:它先取得沒有資料的外殼,12 秒後,同一位訪客從登記在 OpenAI 名下的網段回來,下載 JavaScript,再從程式碼取出資料。第 2 頁也有相同行為。
第 4 頁不必下載另一份程式檔,它直接讀 HTML 裡的資料區塊。第 5 頁則只下載含價格的那一份程式檔,沒有下載框架的其他檔案。這些紀錄顯示,它不是像一般瀏覽器那樣完整載入頁面,而是進一步讀取程式碼。就像別的工具只看門口菜單,它走進廚房翻食譜。
ChatGPT App 多做了一步
① 打開網頁
先收到沒有商品資料的網頁外殼。
② 另外下載程式檔
接著索取含有資料的 JavaScript 檔案。
③ 從程式碼找出資料
讀出文字,連編碼過的資料也解出來。
這個例外不能成為網站設計的依靠。它只發生在特定 App 與模型,而且是我們明確請它讀指定網頁時。ChatGPT 的一般網頁擷取工具並沒有做這件事,您的客戶也不一定使用同一種 App、模型或模式。
用 Next.js 做網站,也會有問題嗎?
不一定。Next.js 通常會在伺服器端產生頁面,文字本來就在 HTML 裡。我們用第 5 頁分開測試三種資料送達方式,結果如下。
| 第 5 頁的資料 | ChatGPT App | Claude App | Gemini App | ChatGPT API | Claude API |
|---|---|---|---|---|---|
| 伺服器直接產生的文字 | 讀到 | 讀到 | 讀到 | 讀到 | 讀到 |
| 稍後串流的文字(React Suspense) | 讀到 | 未讀到 | 讀到 | 讀到 | 未讀到 |
| 由瀏覽器程式加入的文字 | 讀到 | 未讀到 | 未讀到 | 未讀到 | 未讀到 |
伺服器直接產生的部分,五種工具都讀到了。Suspense 裡的資料,Claude 只讀到等待中的占位文字;Claude App 甚至回報頁面寫著「Loading details...」。而由瀏覽器程式加入的資料,只有 ChatGPT App 讀到。
也要留意實驗條件:我們擷取 Next.js 14 伺服器實際產生的內容,再以檔案提供。因此串流部分與其餘內容是一起送達,這不是所有即時串流情境的測試。
Google 的 AI 摘要怎麼回答?
Google AI 摘要不能用同樣方式直接交付網址,因此我們改用產品名稱搜尋。Google 尚未找到實驗網站,AI 摘要卻在兩天都把其中一項產品和名稱相似的真實香氛工作室連在一起。第二天,它一方面說某項產品不存在,一方面又說公司名稱是某網站虛構的城鎮。ChatGPT 與 Claude 用網路搜尋回答相同問題時,則表示找不到。
這是另一條搜尋路徑的觀察,不能和前面「直接給網址」的讀取測試混為一談,也不能推論所有 Google AI 摘要都會出現相同錯誤。
對經營網站的人,實際要做什麼?
先不用記住 SSR 等縮寫。第 1 頁其實只是靜態 HTML 檔,不需要即時在伺服器產生,也能被每種受測工具讀懂。真正影響本次結果的是:重要文字是否已經放在伺服器送出的可讀內容裡。伺服器端渲染、靜態產生及預先渲染,都可能做到。
- 先檢查商品、價格與聯絡資訊。用 Chrome 打開網站,按右鍵選「檢視網頁原始碼」,搜尋商品名稱或價格。要出現在頁面文字裡,不能只是藏在
<script開頭的程式或資料區塊。這是初步檢查,不是能被推薦的保證。 - 把檢查結果交給網站製作人員。可以直接問:「我們的重要資訊,能不能在不執行 JavaScript 的情況下讀到?」不必一開始就要求整站重做。
- 如果使用 Next.js,確認重要資料的呈現方式。請開發者把商品、價格與聯絡方式直接由伺服器產生,避免關鍵資料只放在 Suspense 或等待瀏覽器執行後才出現的內容裡。
- 把『讀得到』和『會推薦』分開檢查。前者是資料取得問題;後者還涉及是否被找到、內容是否符合提問,以及 AI 如何選擇來源。可接著看五步驟檢查 AI 是否推薦您的網站。
開發者也可以用以下指令查看伺服器直接回傳的內容:
curl -s https://yoursite.com/pricing若想先知道自己的網站有沒有這類問題,可以使用免費網站掃描。它檢查不執行 JavaScript 時能否讀到內容、robots.txt 允許哪些 AI 爬蟲,以及結構化資料,不需註冊。
這篇還沒有回答什麼?
第一篇測的是直接讀取頁面。許多 AI 回答也可能透過搜尋索引取得資料,而不是當場到您的網站閱讀。Google 的JavaScript 搜尋說明文件表示,它會在建立索引的流程中執行 JavaScript;我們也觀察到 OpenAI 與 Anthropic 的訓練爬蟲下載過實驗網站的 JavaScript。
所以,當買家只問虛構公司的名稱、不提供網址時,這些資料會不會出現在回答裡?這是第二篇要追蹤的問題。我們暫時保留公司名稱與網址,避免破壞這部分實驗。
測試方法與限制
- 日期與範圍:一個虛構網站、五個產品頁。第 1 至 3 頁於 2026 年 10 月 21 日測試,第 4、5 頁於 10 月 22 日測試。
- 提問:請 AI 讀取指定網址,列出產品用途、最初測試地點、吉祥物與價格。原始測試以英文進行,本篇是繁體中文說明,並非另做一次中文實驗。
- App:ChatGPT(GPT-6.1 Sol)、Claude(Opus 5.5,medium effort)、Gemini(Auto),使用可上網的一般對話,每頁開一個新對話。
- API:OpenAI
gpt-4.1-mini搭配 web search;Anthropicclaude-sonnet-5搭配 web fetch。App 與 API 是不同使用方式,不能把結果合併成同一項產品的固定能力。 - Google:兩天皆以產品名稱搜尋,美國地區、英文。
- 第 5 頁:使用 Next.js 14 App Router,保存框架伺服器的實際輸出並以檔案提供,串流部分與其餘內容一起送達。
- Claude App:10 月 21 日使用約 20 分鐘前 API 測試期間擷取的副本;副本也沒有 JavaScript。10 月 22 日改給新網址,使它自行擷取第 4、5 頁。
- 證據:CDN 存取紀錄中的請求、使用者代理與 IP 位址。
- 限制:每頁、每種工具各測一次,只有一個網站,結果可能隨模型與工具改變。沒有衡量實際客戶推薦、點擊或成交效果。
常見問題
為什麼 AI 能否讀懂網站,和我的生意有關?
潛在客戶詢問您的公司時,網站可以提供商品、價格與服務細節。如果 AI 讀不到,回答就可能漏掉重要資訊。但讀得到不保證它會找到、引用或推薦您,本次實驗也沒有測量推薦或成交效果。
網站在瀏覽器裡正常,為什麼 AI 讀不到?
有些網站先送出外殼,再由瀏覽器執行 JavaScript 加入文字。人看到的是組合完成的畫面,AI 工具卻可能只取得原本的外殼。本次測試中,五種工具有四種未讀到只放在 JavaScript 或 script 資料區塊裡的實驗資料。
ChatGPT 不是讀到了嗎?還需要調整嗎?
本次是 ChatGPT App 在被要求閱讀指定網址時,額外下載並解讀程式碼,才找到隱藏資料。一般網頁擷取工具沒有做這一步,其他受測工具也沒有相同行為,不能假設每位客戶使用的 AI 都會繞路找到。
用 Next.js 做網站就不利於 AI 搜尋嗎?
不是。五種工具都讀到 Next.js 頁面由伺服器直接產生的文字。差別出現在稍後串流的內容,以及由瀏覽器程式加入的資料。請開發者確認商品、價格與聯絡方式是否已在伺服器送出的可讀內容裡。
不懂程式,可以怎麼檢查?
在 Chrome 打開網站,按右鍵選「檢視網頁原始碼」,搜尋商品名稱或價格。確認它出現在頁面文字中,而非只藏在 script 區塊。也可以使用免費網站掃描,再把結果交給網站製作人員。這是初步讀取檢查,不代表一定會被 AI 推薦。
先看看 AI 能否讀到您的商品與服務
Alice 檢查網站在不執行 JavaScript 時是否有可讀內容,也用買家問題觀察 Google AI 摘要、ChatGPT 與 Claude 的回答。免費方案每週檢查五個問題。
免費試用 Alice